Ringkasan: GoTo meluncurkan model bahasa besar (LLM) open-source 27 miliar parameter pada 19 Oktober 2026 di Bali Tech Week. Model ini disiapkan untuk bahasa Indonesia, Jawa, Sunda, Bali, dan Batak. Bobotnya bisa diunduh gratis di Hugging Face dan dijalankan di server sendiri. Klaim skor tertingginya masih berasal dari pengujian GoTo sendiri.
Apa itu model AI 27 miliar parameter GoTo yang paham bahasa daerah?
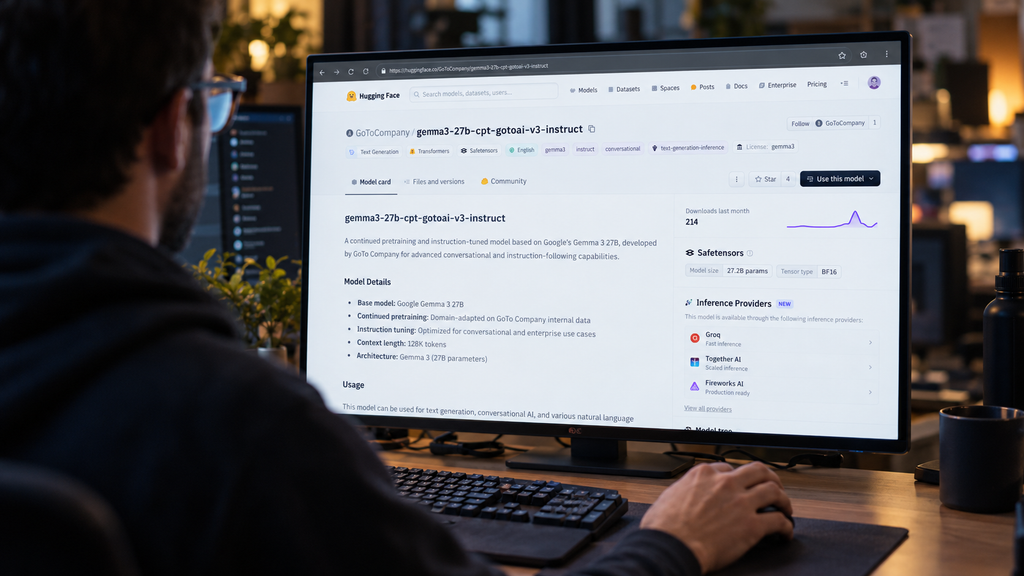
Model AI 27 miliar parameter GoTo adalah large language model open-source yang dirancang untuk memahami bahasa Indonesia dan sejumlah bahasa daerah. Menurut pemberitaan Kontan dan Bisnis.com, model ini mencakup bahasa Jawa, Sunda, Bali, dan Batak. Publik bisa mengaksesnya gratis lewat Hugging Face dengan nama repositori gemma3-27b-cpt-gotoai-v3-instruct.
Artinya sederhana. Anda tidak perlu membayar lisensi komersial lewat API pihak ketiga untuk mulai bereksperimen. Anda mengunduh bobotnya, menyalakannya di server sendiri, lalu menyesuaikannya dengan kebutuhan.
Kabar ini punya latar yang panjang. GoTo adalah hasil merger dua raksasa digital lokal, dan kami pernah mengulas sejarah merger GoTo dan Tokopedia di Indonesia. Kini perusahaan yang sama masuk ke ranah infrastruktur AI.
Fakta kunci peluncuran: apa yang sudah dikonfirmasi?
Berikut fakta yang bisa dicek ke sumber publik per 22 Oktober 2026.
| Aspek | Fakta | Sumber |
| Tanggal peluncuran | Senin, 19 Oktober 2026 | detikBali, detikInet |
| Lokasi | Bali Tech Week 2026, Sanur, Bali | Bisnis.com, detikBali |
| Pengumuman | CEO Grup GoTo, Hans Patuwo | Kontan |
| Ukuran model | 27 miliar parameter | Kontan, Hugging Face |
| Bahasa yang disebut | Indonesia, Jawa, Sunda, Bali, Batak | Bisnis.com, detikBali |
| Lisensi | Tercantum gemma pada metadata README | Hugging Face |
| Distribusi | Gratis untuk publik di Hugging Face | Kontan, youngster.id |
| Mitra data Batak | Universitas Sumatera Utara (USU) | Bisnis.com |
| Keterlibatan kampus | Mahasiswa dari tujuh universitas | detikInet |
Tabel ini sengaja hanya memuat hal yang terverifikasi. Hal yang belum terkonfirmasi, seperti angka benchmark detail dan ukuran korpus latih, kami bahas terpisah di bagian batasan.
Mengapa model AI lokal ini penting di 2026?
Jawabannya ada pada cara orang Indonesia sehari-hari berbahasa. CEO Grup GoTo Hans Patuwo menyoroti bahwa sistem AI global sering kesulitan menangkap cara masyarakat berkomunikasi. Contohnya singkatan sehari-hari dan bahasa daerah yang dipakai sejak kecil di rumah, seperti dilaporkan detikInet.
Bagi pengembang, ada tiga dampak praktis.
Pertama, akses. Menurut Kontan dan Bisnis.com, ukuran 27 miliar parameter dinilai cukup kuat untuk tugas bahasa yang rumit. Namun ukuran itu tetap bisa dijalankan di server universitas, startup, atau lembaga pemerintah tanpa pusat data raksasa.
Kedua, kendali data. Model yang berjalan di server sendiri berarti dokumen internal tidak harus keluar ke layanan pihak ketiga. Ini poin penting bagi instansi publik. Poin ini adalah analisis kami, bukan klaim GoTo.
Ketiga, konteks lokal. Basis penggunanya sangat besar. Kami membahas skala audiens digital Indonesia di artikel pengguna internet Indonesia 2026. Layanan yang melayani audiens sebesar itu butuh AI yang memahami variasi bahasanya.
Pemberitaan juga mengaitkan peluncuran ini dengan visi Indonesia Digital 2045 dan agenda kedaulatan AI. Itu bingkai yang dipakai GoTo dan media, bukan hasil ukur independen.
Di balik layar: dasar teknis model GoTo-AI
Halaman model di Hugging Face menjelaskan bahwa GoTo-AI adalah kumpulan LLM yang dilatih dan di-instruct-tune untuk budaya dan bahasa Indonesia. Model ini memakai arsitektur Gemma 3, dipadukan dengan model lokal khusus.
Beberapa detail teknis yang tampak di repositori:
- Nama repositori: GoToCompany/gemma3-27b-cpt-gotoai-v3-instruct.
- Jenis: text generation, tersedia lewat pustaka Transformers dan format safetensors.
- Total ukuran repositori yang tercatat: 110 GB, dengan bobot terbagi dalam 12 berkas safetensors.
- Metadata bahasa pada README (commit yang kami baca): en, id, jv, su.
Kami membaca “cpt” pada nama repositori sebagai continued pre-training. Ini tebakan dari konvensi penamaan, jadi konfirmasi lewat model card resmi sebelum Anda mengutipnya.
Ada satu hal yang patut dicermati. Peluncuran menyebut bahasa Bali dan Batak, sedangkan metadata README hanya mencantumkan kode bahasa Inggris, Indonesia, Jawa, dan Sunda. Ini belum tentu kontradiksi, karena metadata sering lebih sempit dari isi data latih. Tetap saja, uji sendiri kualitas bahasa Bali dan Batak sebelum memakainya di produksi.
GoTo sudah lama membangun lini ini. Halaman organisasi GoToCompany di Hugging Face memuat koleksi GoTo-AI V3, Sahabat-AI V2, dan Sahabat-AI V1. Bisnis.com juga melaporkan bahwa riset open-model perusahaan dimulai sejak 2024. Artinya, model 27 miliar parameter ini adalah kelanjutan, bukan proyek yang muncul dari nol.
Bahasa yang didukung dan asal datanya
Menurut laporan Bisnis.com, Surabaya Inside, dan detikBali, model ini dilatih dengan teks berbahasa Indonesia dan bahasa daerah. Sumbernya media, situs publik, dan mitra perguruan tinggi.
Untuk bahasa Batak, GoTo bermitra langsung dengan Universitas Sumatera Utara. Tujuannya merekam penggunaan bahasa yang relevan dengan kondisi masa kini. Youngster.id melaporkan hal serupa, yaitu kolaborasi untuk mengumpulkan data penggunaan bahasa yang akurat.
Kemitraan akademik ini sinyal kualitas yang masuk akal. Bahasa daerah punya data digital yang jauh lebih sedikit daripada bahasa Indonesia. Data dari penutur nyata di kampus biasanya lebih bersih daripada hasil menyapu situs acak. Meski begitu, kami belum menemukan rincian jumlah token atau komposisi korpus per bahasa. Karena itu kami tidak menuliskan angkanya.
Cara membaca klaim “skor tertinggi di semua bahasa daerah”
Kontan dan MediaKompeten melaporkan bahwa model ini meraih skor tertinggi pada setiap bahasa daerah yang diuji. Pembandingnya adalah model open-source sekelasnya, dan hasil itu berasal dari pengujian GoTo sendiri.
Klaim ini menarik, tetapi baca dengan hati-hati. Ada empat alasannya.
- Pengujinya produsen sendiri. Belum ada replikasi independen yang kami temukan per hari ini.
- Pembandingnya terbatas. Frasa “sekelasnya” berarti model open-source dengan ukuran serupa, bukan semua model.
- Cakupan tugas belum jelas. Skor tinggi pada satu jenis tes tidak otomatis berarti bagus untuk chatbot layanan pelanggan.
- Ada papan peringkat. Halaman GoToCompany di Hugging Face memuat Space bernama GoTo AI Leaderboard. Anda bisa memeriksa metodenya langsung.
Rekomendasi praktis: buat set uji kecil dari kasus nyata Anda, misalnya 50 pertanyaan dalam bahasa Jawa atau Sunda. Bandingkan hasilnya dengan model yang sekarang Anda pakai. Hasil itu lebih berguna daripada skor di slide peluncuran.
Kebutuhan perangkat keras: seberapa berat menjalankan model 27B?
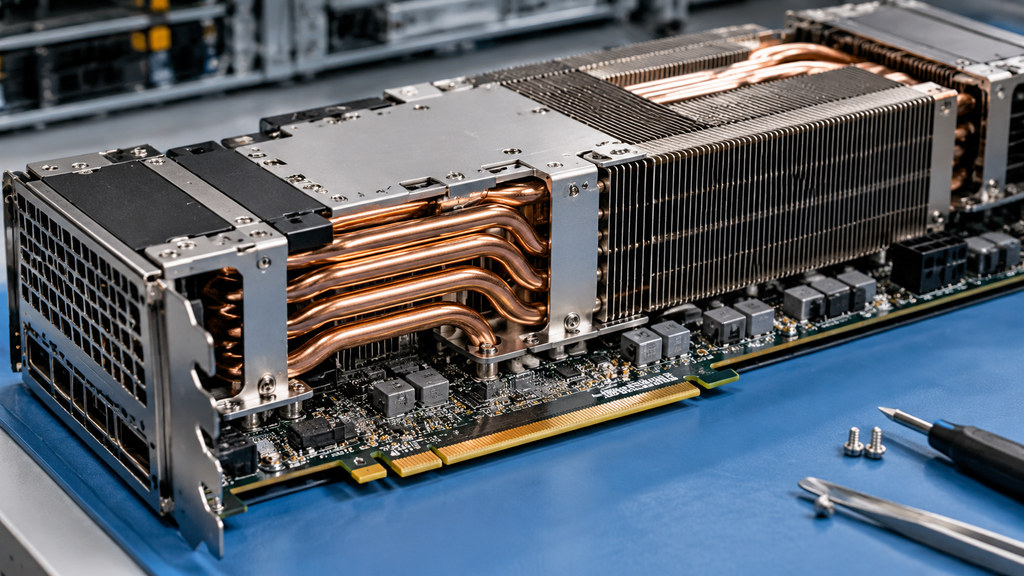
GoTo menyebut model ini cukup ringan untuk berjalan di server mandiri tanpa pusat data raksasa. “Ringan” di sini relatif terhadap model ratusan miliar parameter. Untuk laptop biasa, 27 miliar parameter tetap berat.
Perhitungan kasar kami, hanya untuk bobot teks dan belum termasuk cache konteks:
| Presisi | Rumus | Perkiraan memori bobot |
| 16-bit | 27 miliar × 2 byte | sekitar 54 GB |
| 8-bit | 27 miliar × 1 byte | sekitar 27 GB |
| 4-bit | 27 miliar × 0,5 byte | sekitar 13,5 GB |
Angka di atas adalah estimasi aritmetika kami, bukan spesifikasi resmi GoTo. Kebutuhan nyata bergantung pada panjang konteks, ukuran batch, dan framework. Untuk uji coba serius, siapkan GPU server dengan memori besar atau gunakan versi terkuantisasi.
Harga memori dan perangkat keras juga ikut naik di era AI. Kami mengulas tren ini di prediksi harga RAM di era AI. Hitung anggaran perangkat keras sebelum Anda memutuskan self-hosting.
Cara implementasi model GoTo-AI 27B — step by step
Halaman Hugging Face menampilkan beberapa jalur penggunaan: Transformers, vLLM, SGLang, dan Docker Model Runner. Berikut alur yang paling ringkas.
- Siapkan lingkungan: pastikan GPU server dengan memori cukup, lalu instal Python dan pustaka inferensi pilihan Anda.
- Baca model card dan lisensi: buka halaman repositori GoToCompany di Hugging Face dan periksa ketentuan lisensi gemma sebelum pemakaian komersial.
- Unduh model: gunakan repositori GoToCompany/gemma3-27b-cpt-gotoai-v3-instruct. Siapkan ruang disk lapang karena repositori tercatat 110 GB.
- Jalankan server inferensi: contoh perintah vLLM yang tertera di halaman model:
vllm serve “GoToCompany/gemma3-27b-cpt-gotoai-v3-instruct”
- Atau muat via Transformers: contoh dasar dari halaman yang sama:
from transformers import pipeline
pipe = pipeline(
“text-generation”,
model=”GoToCompany/gemma3-27b-cpt-gotoai-v3-instruct”
)
- Uji dengan data Anda sendiri: siapkan prompt dalam bahasa Indonesia dan bahasa daerah target, lalu nilai hasilnya dengan penutur asli.
- Pasang pagar pengaman: tambahkan pemeriksaan keluaran sebelum model menyentuh pengguna akhir.
Satu catatan teknis penting. Pada commit README yang kami baca, contoh kode menyebut placeholder GoToCompany/GoTo-AI-Gemma-3-27B-IT dengan komentar agar ID model diganti ke path repo yang sebenarnya. Selalu salin nama repositori dari halaman model, bukan dari contoh yang belum diperbarui.
7 skenario penerapan yang masuk akal
Surabaya Inside melaporkan bahwa model ini bisa dipakai untuk fitur penjawab pertanyaan, peringkasan dokumen, dan penerjemahan bahasa. Tiga skenario pertama di bawah mengikuti laporan itu. Sisanya adalah analisis kami.
| # | Skenario | Dasar | Catatan |
| 1 | Penjawab pertanyaan (tanya-jawab) | Dilaporkan media | Uji dengan pertanyaan lokal nyata |
| 2 | Peringkasan dokumen | Dilaporkan media | Cocok untuk dokumen berbahasa Indonesia |
| 3 | Penerjemahan Indonesia–daerah | Dilaporkan media | Verifikasi oleh penutur asli |
| 4 | Asisten layanan pelanggan multibahasa | Analisis kami | Perlu pagar pengaman dan eskalasi ke manusia |
| 5 | Pencarian internal dokumen instansi | Analisis kami | Keuntungan self-hosting untuk data sensitif |
| 6 | Alat bantu riset linguistik dan pelestarian bahasa | Analisis kami | Berpotensi dengan kampus mitra |
| 7 | Dasar fine-tuning untuk domain khusus | Analisis kami | Cek izin lisensi untuk turunan model |
Jika Anda membangun agen otomatis di atasnya, pelajari dulu dampak AI agentik pada pekerjaan. Kami membahasnya di AI agentik dan dunia kerja 2026.
Batasan dan risiko yang perlu Anda ketahui
Model ini menarik, tetapi bukan solusi tanpa catatan.
Benchmark belum independen. Klaim skor tertinggi berasal dari pengujian GoTo. Tunggu evaluasi pihak ketiga atau buat uji sendiri.
Lisensi perlu dibaca. Metadata README mencantumkan lisensi gemma. Itu lisensi khusus keluarga model Gemma, bukan lisensi open-source generik. Periksa ketentuannya untuk pemakaian komersial dan turunan.
Halusinasi tetap mungkin. Semua LLM bisa menghasilkan jawaban keliru dengan nada yakin. Terjemahan bahasa daerah untuk konteks formal, hukum, atau kesehatan wajib ditinjau manusia.
Cakupan bahasa bisa tidak merata. Bahasa Indonesia hampir pasti paling kuat. Bahasa dengan data lebih sedikit perlu diuji lebih ketat.
Biaya operasional nyata. Gratis diunduh bukan berarti gratis dijalankan. Listrik, GPU, dan tenaga insinyur tetap perlu dianggarkan.
Satu lagi soal kualitas informasi di internet. Banyak konten otomatis kini membanjiri web, dan kami membahas fenomenanya di AI slop yang menguasai internet. Model lokal yang bagus tetap butuh data dan peninjau manusia agar tidak menambah kebisingan.
Posisi model ini dalam peta AI Indonesia
Model 27B ini bukan satu-satunya karya GoTo. Halaman organisasi GoToCompany menggambarkan rangkaian GoTo-AI: keluarga unggulan 70B, serta keluarga 9B dan 8B dengan varian base dan instruct. Model 27 miliar parameter menempati posisi di antaranya.
Dari sisi strategi, ukuran menengah punya logika yang jelas. Model sangat besar unggul secara kemampuan, tetapi mahal dioperasikan. Model kecil murah, tetapi lebih terbatas pada tugas bahasa yang rumit. Ukuran menengah mencoba menyeimbangkan keduanya. Itu pula alasan yang disampaikan GoTo menurut Bisnis.com.
Untuk gambaran lebih luas tentang inovasi AI generatif di tanah air, baca rangkuman inovasi generative AI di Indonesia. Untuk konteks AI sebagai fondasi layanan digital, lihat bukti AI menjadi tulang punggung digital.
Apa yang perlu dipantau dalam 30 hari ke depan?
Ada beberapa hal yang layak Anda awasi setelah rilis ini.
- Model card final. Perhatikan pembaruan README, daftar bahasa, dan detail data latih.
- Evaluasi independen. Cari hasil uji dari komunitas atau akademisi yang membandingkan model ini dengan pesaing sekelasnya.
- Versi terkuantisasi komunitas. Biasanya muncul cepat setelah rilis dan menurunkan kebutuhan GPU.
- Studi kasus penerapan. Instansi atau startup yang lebih dulu mencoba akan memberi gambaran biaya dan kualitas riil.
FAQ — Model AI 27 Miliar Parameter GoTo yang Paham Bahasa Daerah
Apa itu model AI 27 miliar parameter GoTo yang paham bahasa daerah?
Model AI 27 miliar parameter GoTo adalah large language model open-source yang diluncurkan 19 Oktober 2026 di Bali Tech Week. Model ini dirancang memahami bahasa Indonesia serta bahasa daerah seperti Jawa, Sunda, Bali, dan Batak, dan bisa diunduh gratis di Hugging Face.
Bagaimana cara memulai menggunakan model AI GoTo 27 miliar parameter?
Cara memulai: 1) buka repositori GoToCompany di Hugging Face dan baca lisensinya, 2) siapkan GPU server dengan memori cukup, 3) unduh model gemma3-27b-cpt-gotoai-v3-instruct, 4) jalankan lewat vLLM atau Transformers, 5) uji dengan prompt bahasa daerah dari kasus nyata Anda.
Berapa biaya model AI 27 miliar parameter GoTo?
Menurut Kontan dan youngster.id, akses ke model ini gratis untuk publik. Biaya yang tersisa adalah infrastruktur Anda sendiri, seperti GPU, listrik, dan tenaga teknis. Lisensi gemma pada metadata README juga perlu dibaca sebelum pemakaian komersial.
Bahasa daerah apa saja yang didukung?
Peluncuran menyebut bahasa Jawa, Sunda, Bali, dan Batak, di samping bahasa Indonesia. Metadata README pada commit yang kami baca mencantumkan kode en, id, jv, dan su. Uji sendiri kualitas bahasa Bali dan Batak sebelum dipakai di produksi.
Apakah klaim skor tertinggi sudah diverifikasi pihak independen?
Belum ada verifikasi independen yang kami temukan per 22 Oktober 2026. Klaim skor tertinggi pada setiap bahasa daerah yang diuji berasal dari pengujian GoTo sendiri terhadap model open-source sekelasnya.
Siapa yang terlibat dalam pengembangannya?
Menurut Bisnis.com dan detikInet, model dikembangkan tim insinyur internal GoTo bersama mahasiswa dari tujuh universitas. Untuk data bahasa Batak, GoTo bermitra dengan Universitas Sumatera Utara.
Sumber utama
- Kontan, “GoTo Luncurkan Ekosistem AI Lewat Model 27 Miliar Parameter”: https://industri.kontan.co.id/news/goto-luncurkan-ekosistem-ai-lewat-model-27-miliar-parameter
- Bisnis.com, “Goto Luncurkan AI LLM Open Source 27 Miliar Parameter, dari Bahasa Jawa Hingga Batak”: https://teknologi.bisnis.com/read/20261019/266/2013711/goto-luncurkan-ai-llm-open-source-27-miliar-parameter-dari-bahasa-jawa-hingga-batak
- detikBali, “Rilis di Bali Tech Week 2026, LLM 27 Miliar Parameter dari GoTo”: https://www.detik.com/bali/bisnis/d-8714525/rilis-di-bali-tech-week-2026-llm-27-miliar-parameter-dari-goto-dukung-kedaulatan-ai-indonesia/amp
- detikInet, “GoTo Rilis Model LLM 27B, Paham Bahasa Indonesia hingga Daerah”: https://inet.detik.com/cyberlife/d-8716074/goto-rilis-model-llm-27b-paham-bahasa-indonesia-hingga-daerah/amp
- Hugging Face, halaman model: https://huggingface.co/GoToCompany/gemma3-27b-cpt-gotoai-v3-instruct
- Hugging Face, organisasi GoToCompany: https://huggingface.co/GoToCompany